MEMO · 03:41
散落在各处
微信收藏、备忘录、Excel、脑子里各存一半。要用的时候谁都找不到谁。
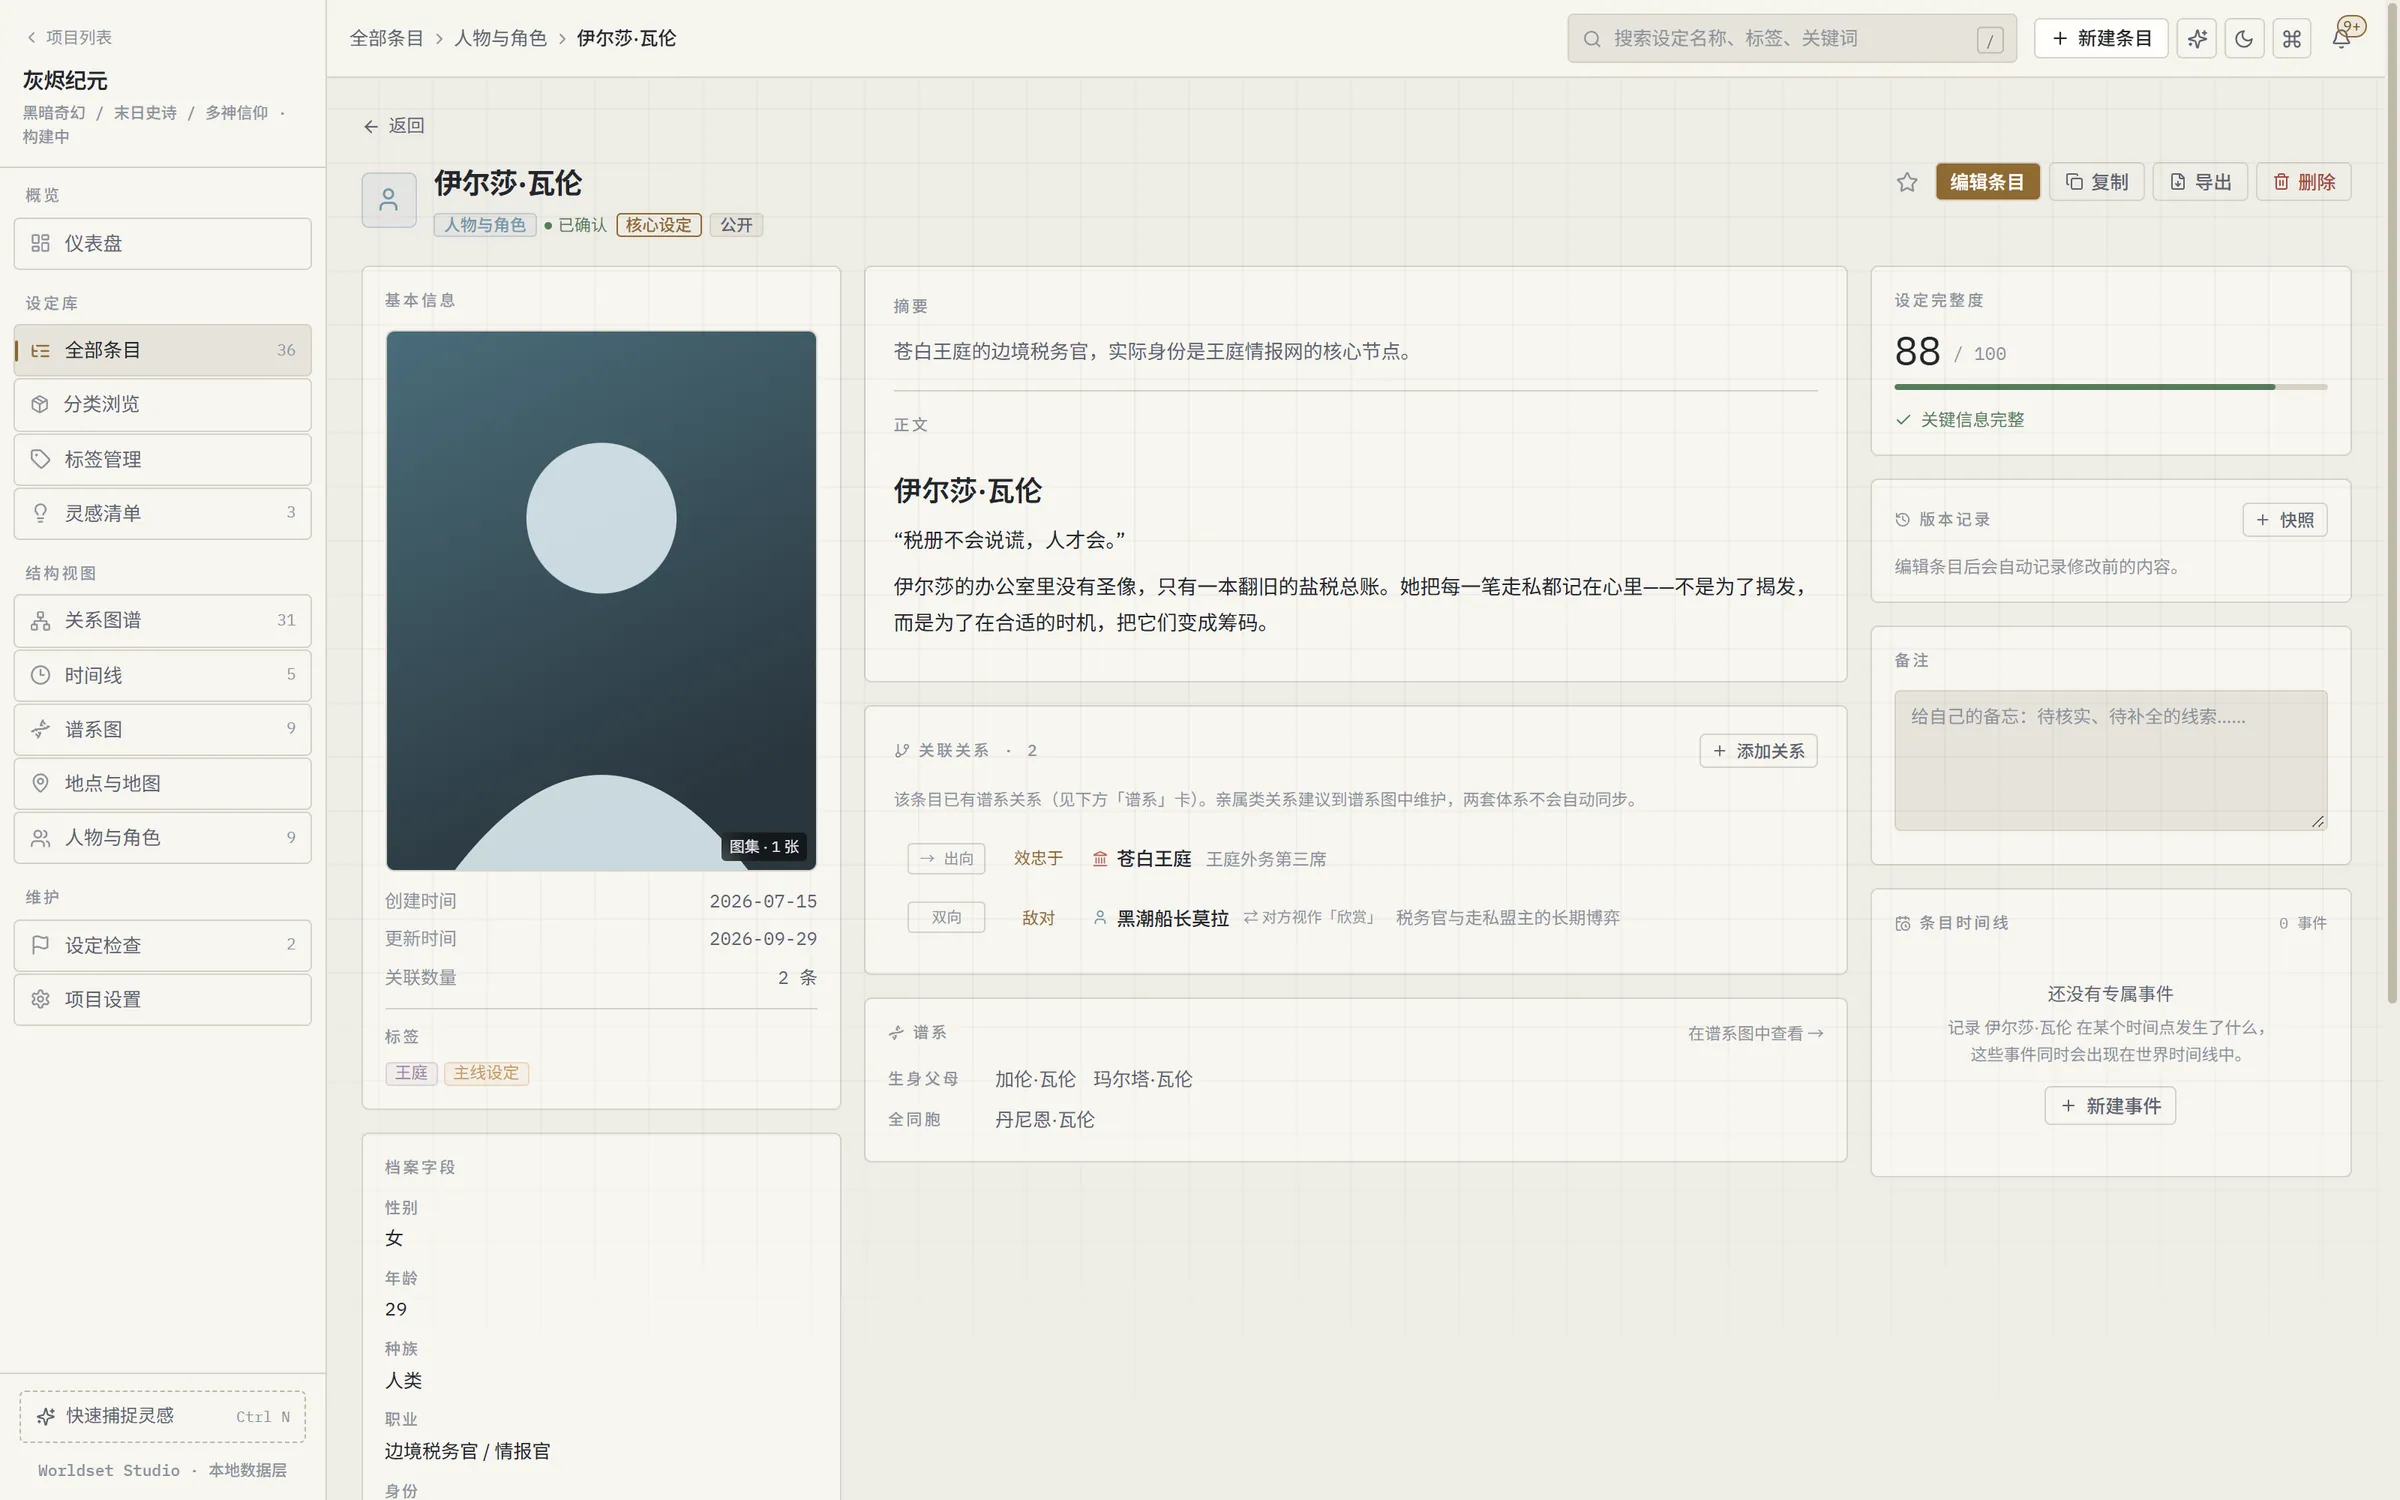
写到第三十章,你想不起来「苍白王都」的守将叫什么、他和主角是什么关系、他第一次出场时死了没有。 于是你翻聊天记录、翻备忘录、翻三个月前的那份文档——写作就这样断了。
MEMO · 03:41
微信收藏、备忘录、Excel、脑子里各存一半。要用的时候谁都找不到谁。
DRAFT · v7
设定改了三次,正文里还留着两个旧版本。没人告诉你哪里冲突了。
HEADS · 1
三十个角色、八个势力,谁效忠谁、谁背叛谁——只靠脑子记,一定会写崩。
下面是这个工作台的真实界面(本地实拍,未做美化)。每一屏都对应一个你每天会用到的动作。
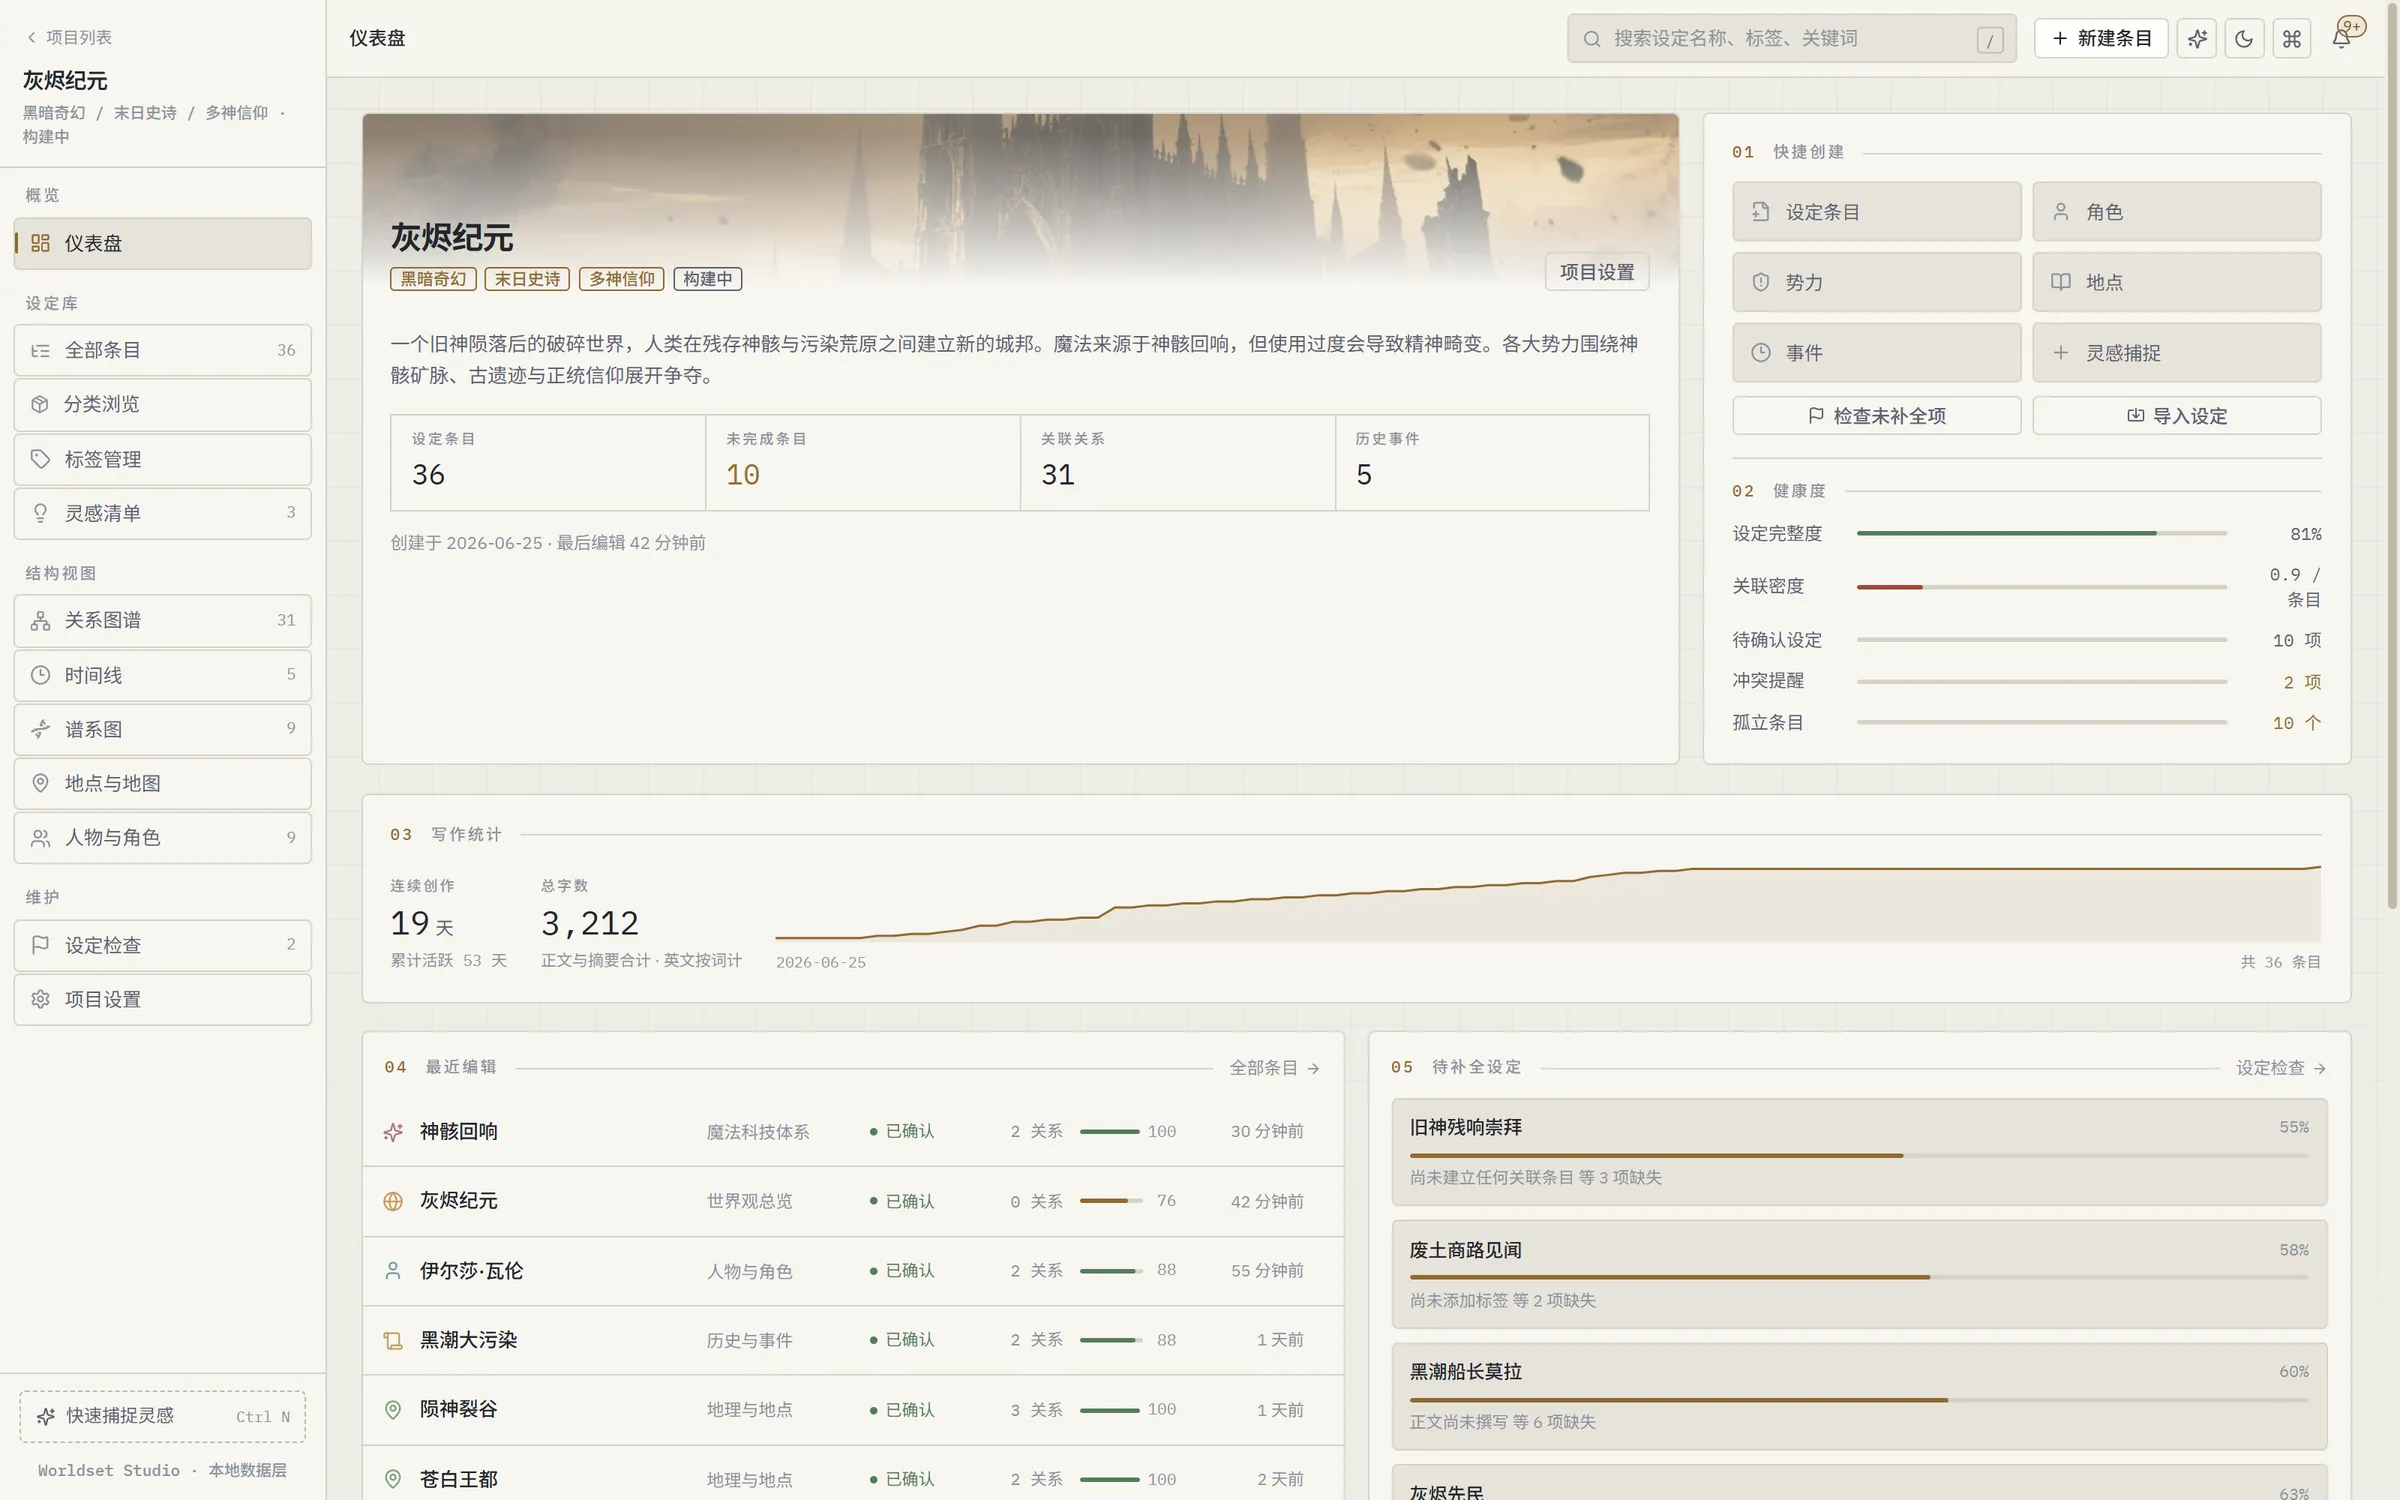
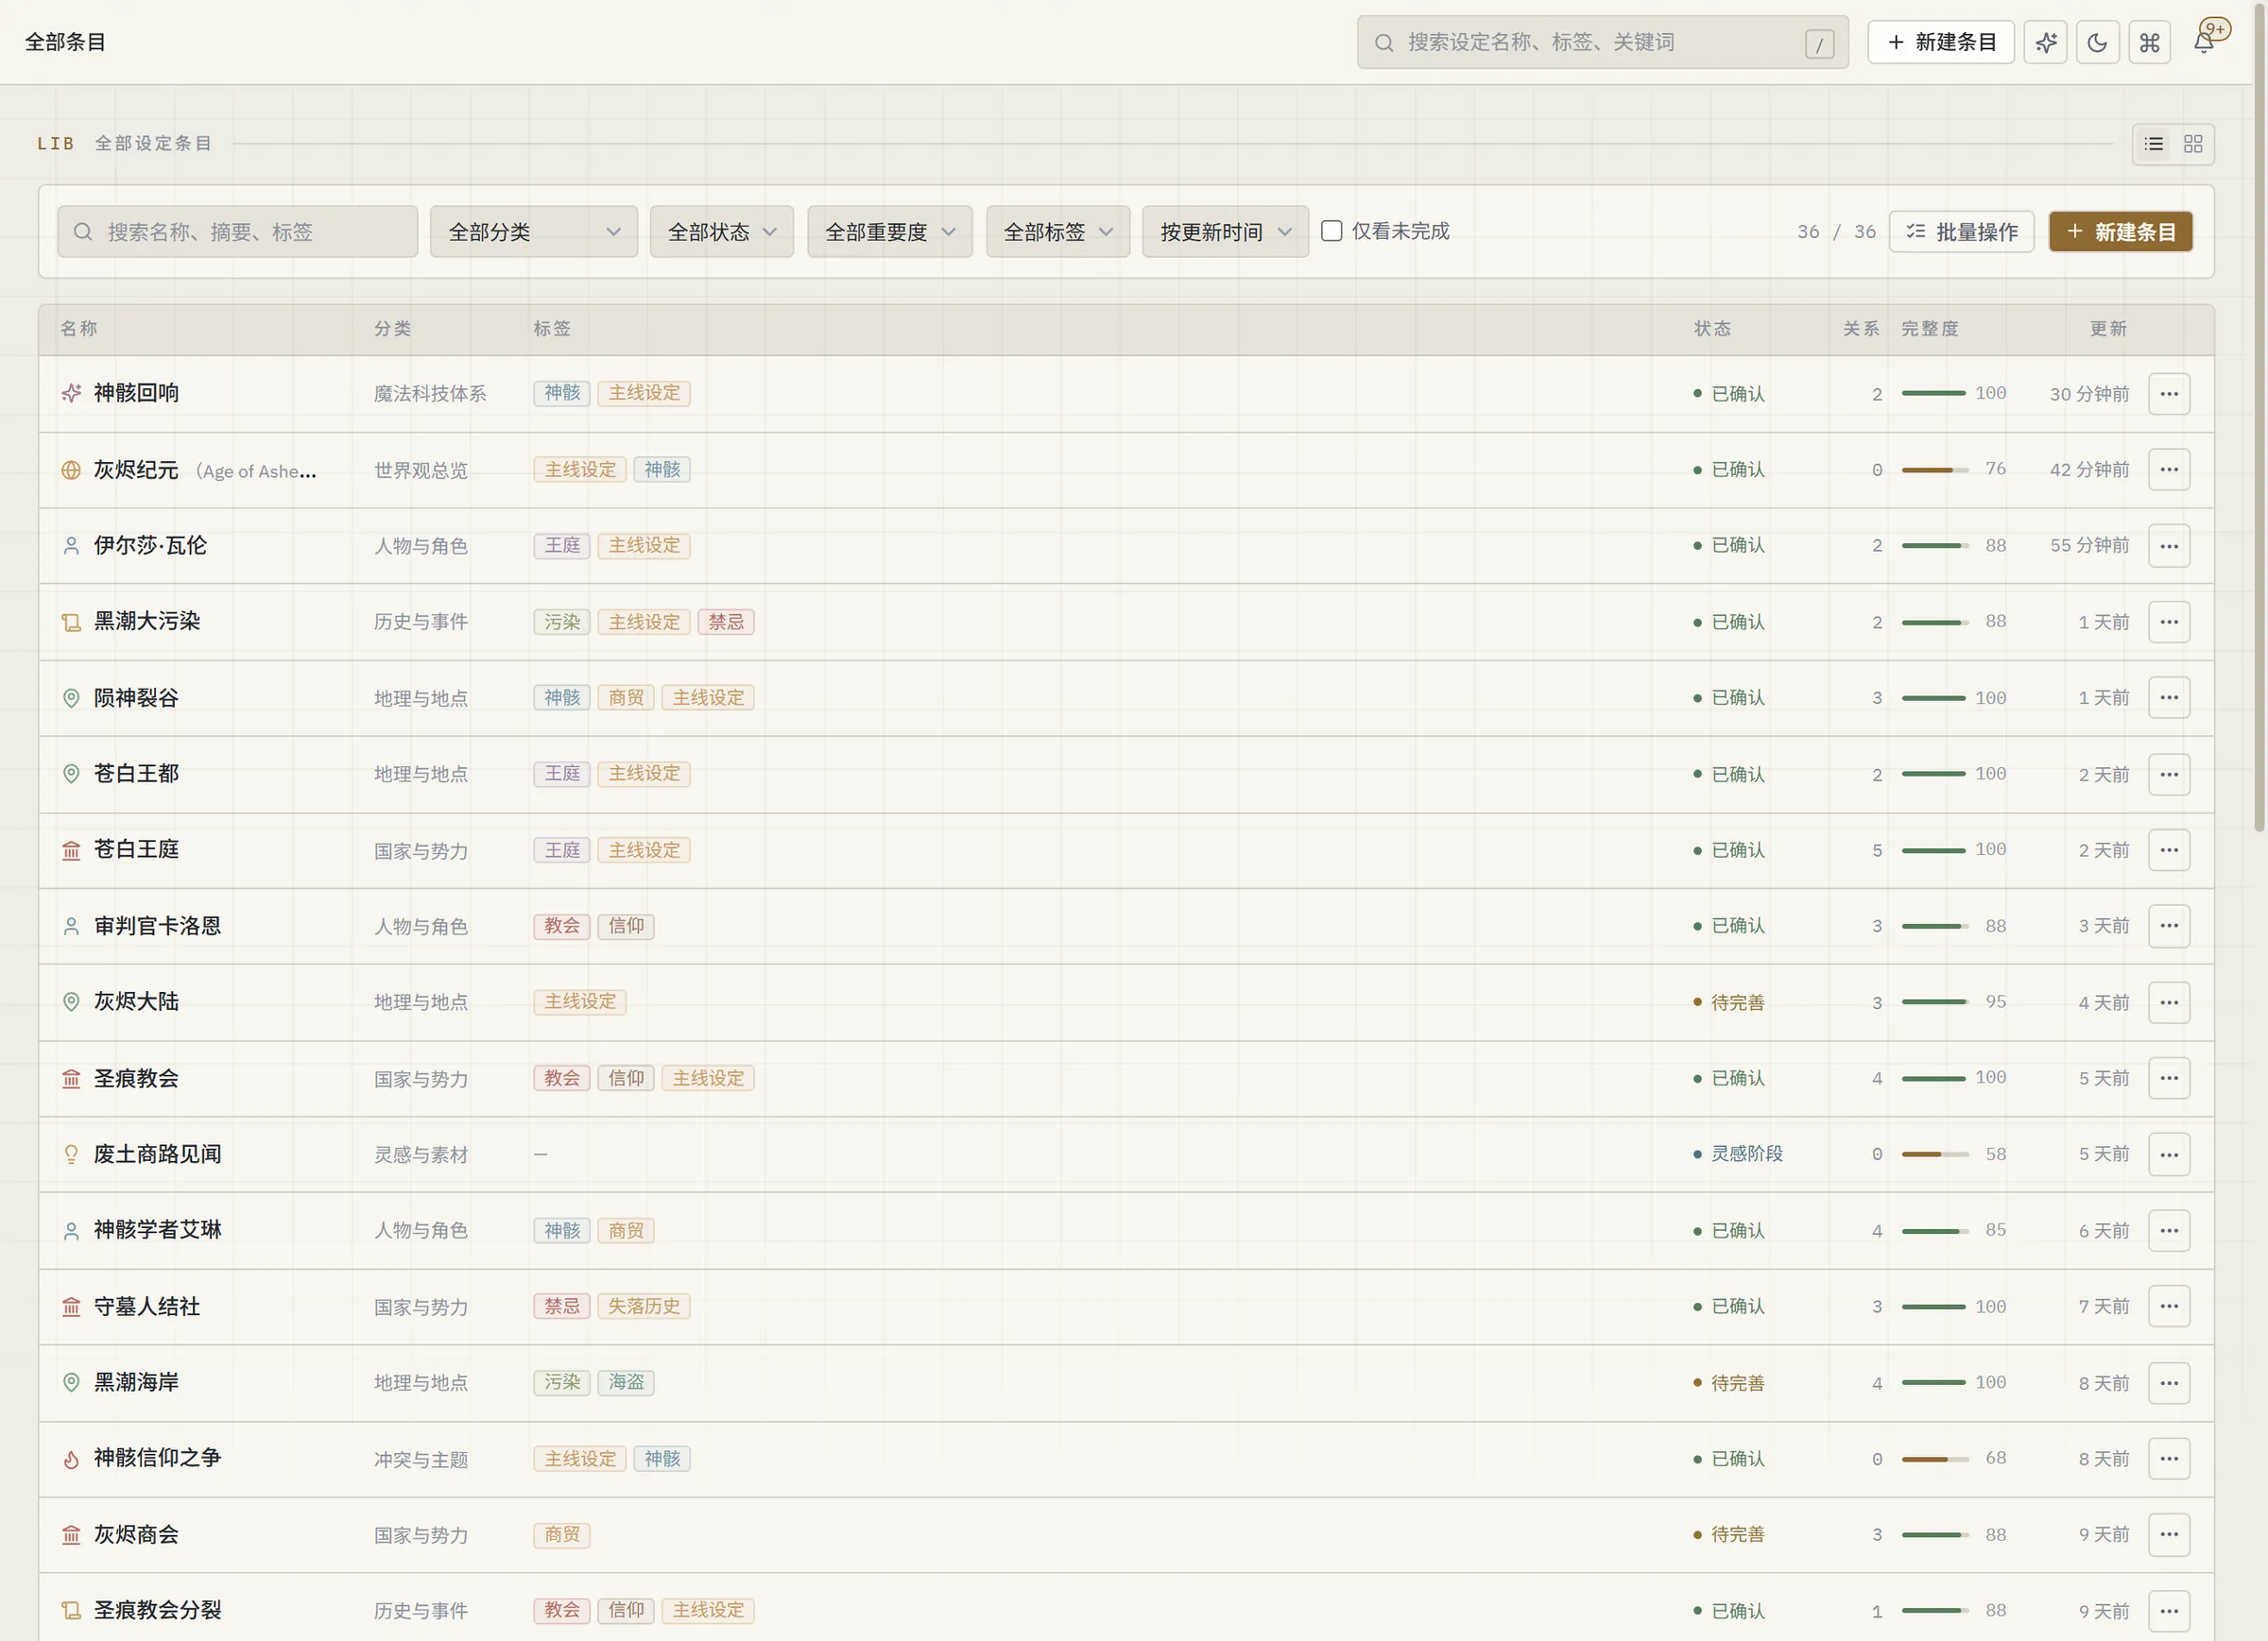
全部设定· 表格 / 卡片两种看法,筛选与批量改状态
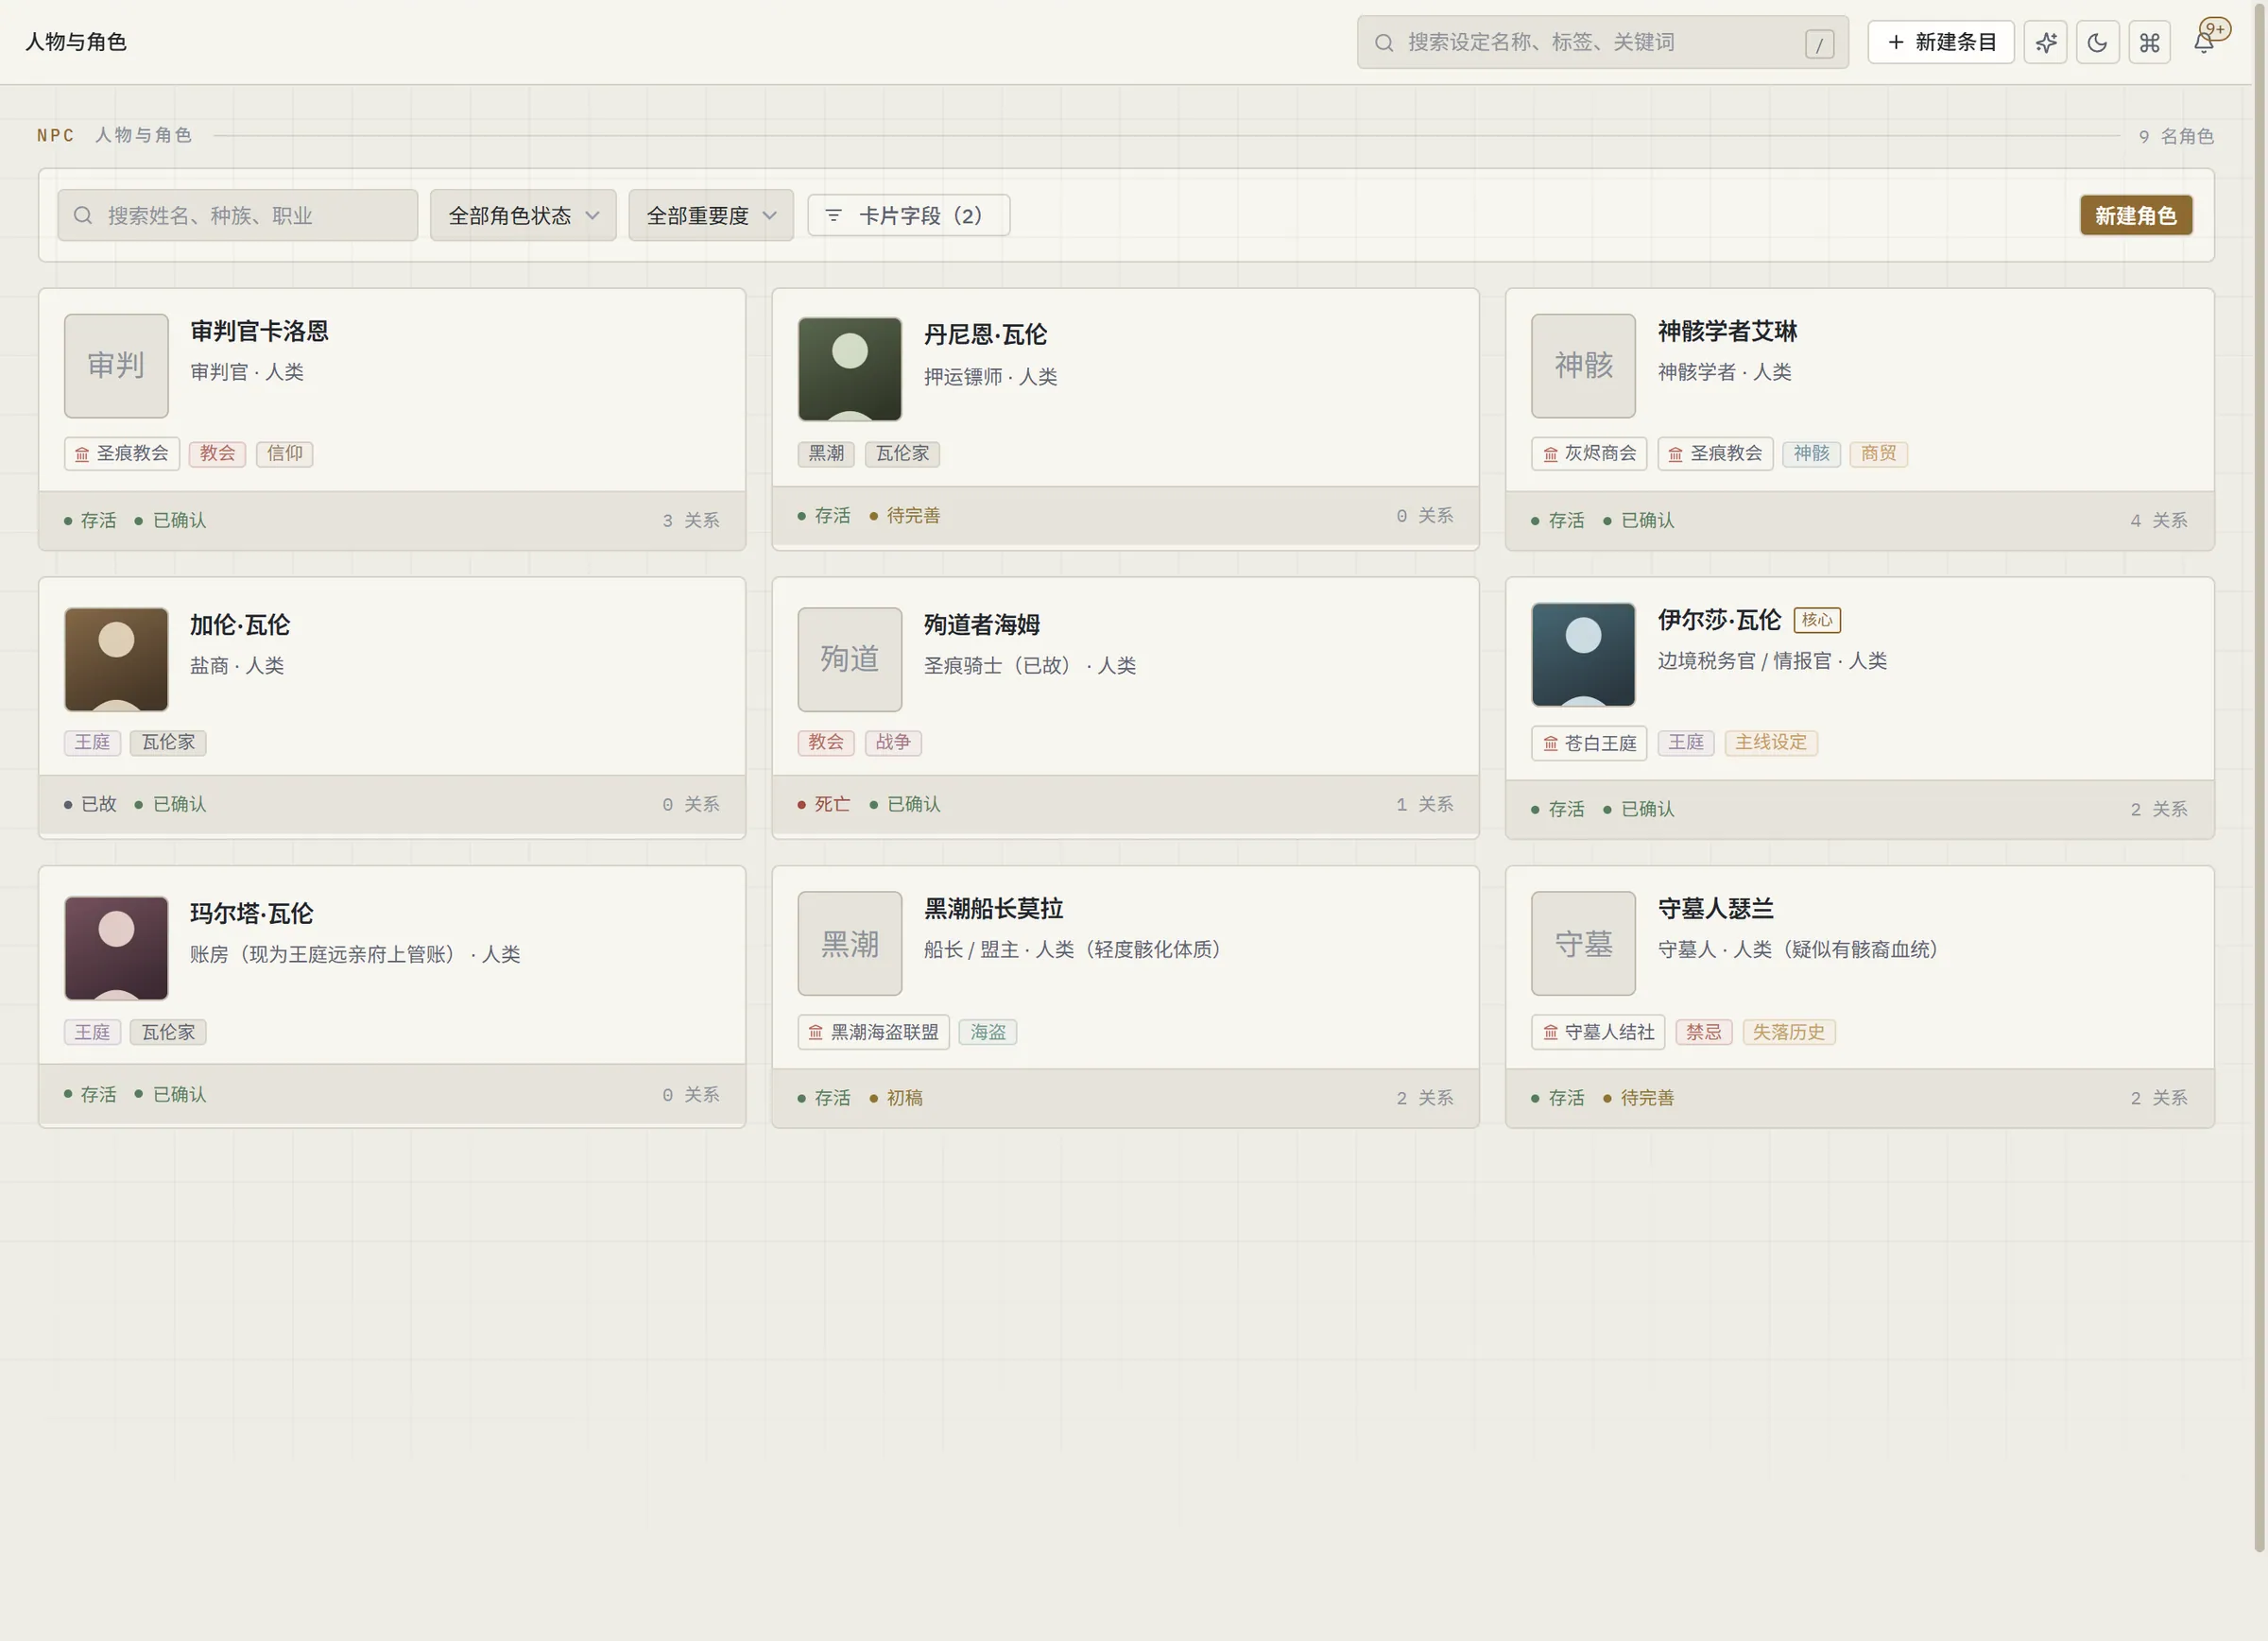
人物与角色· 卡片显示哪些字段,由你自己决定
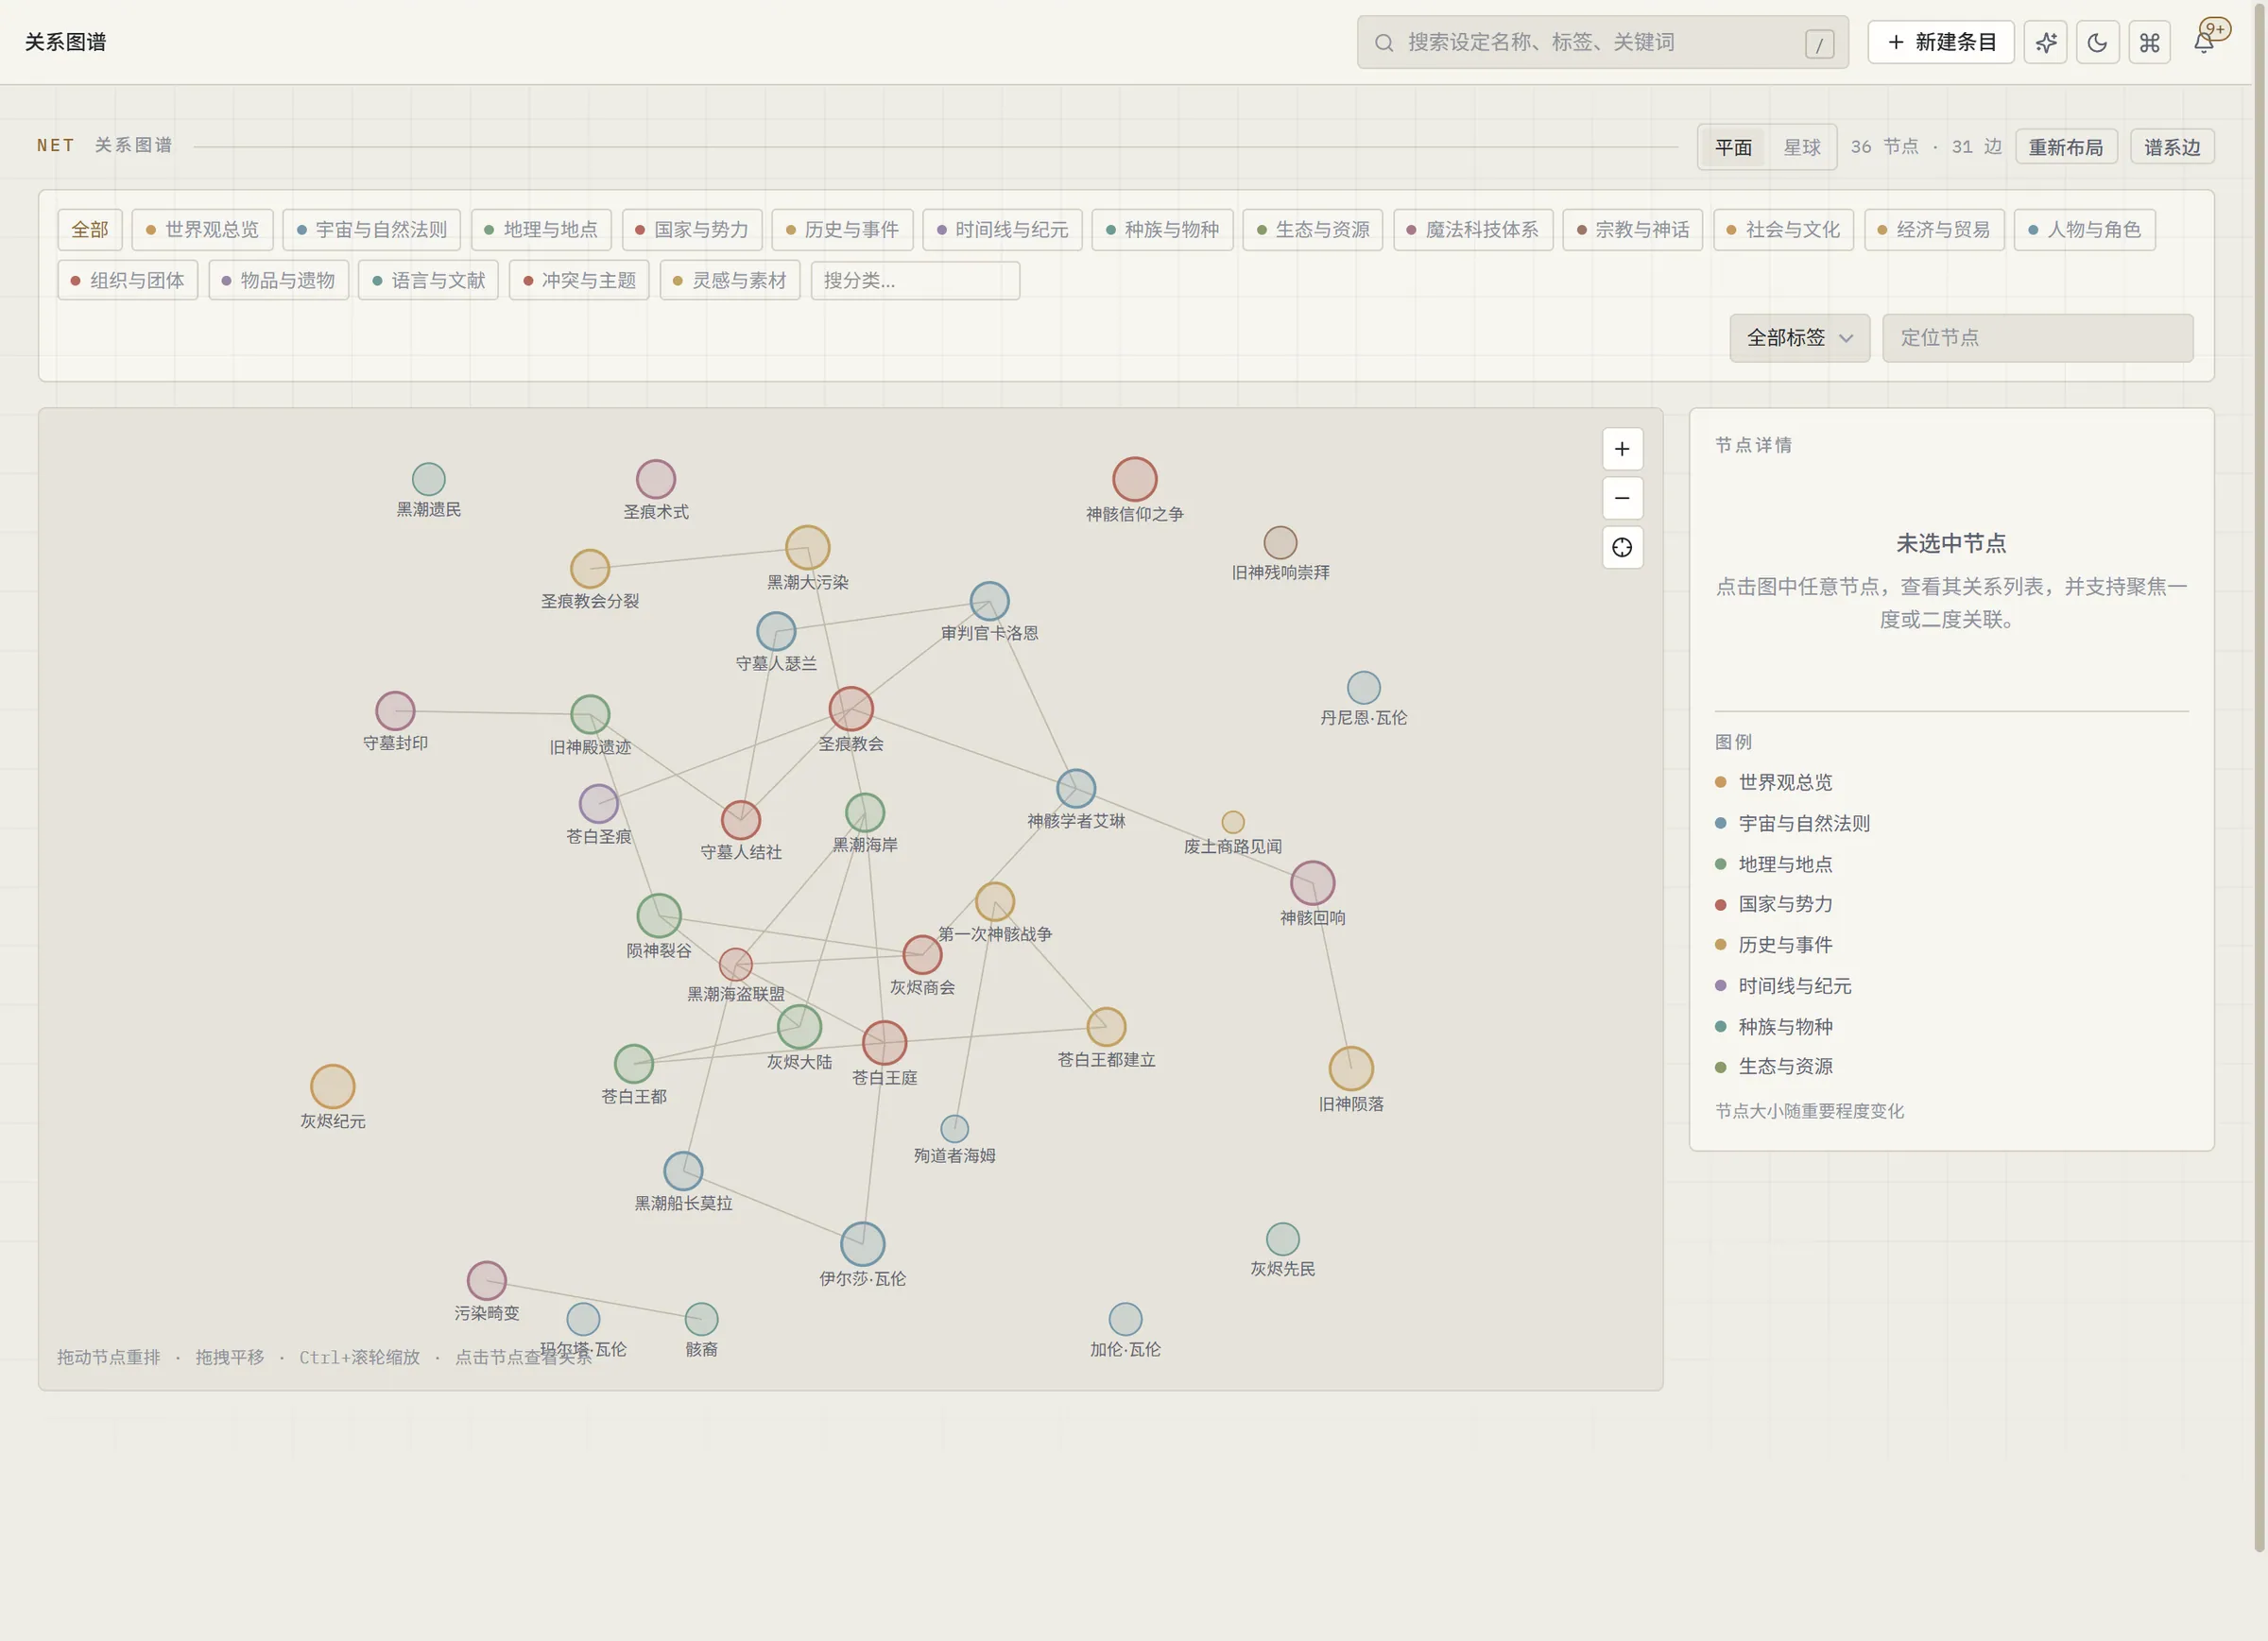
关系图谱· 谁与谁有什么关系,一眼看出
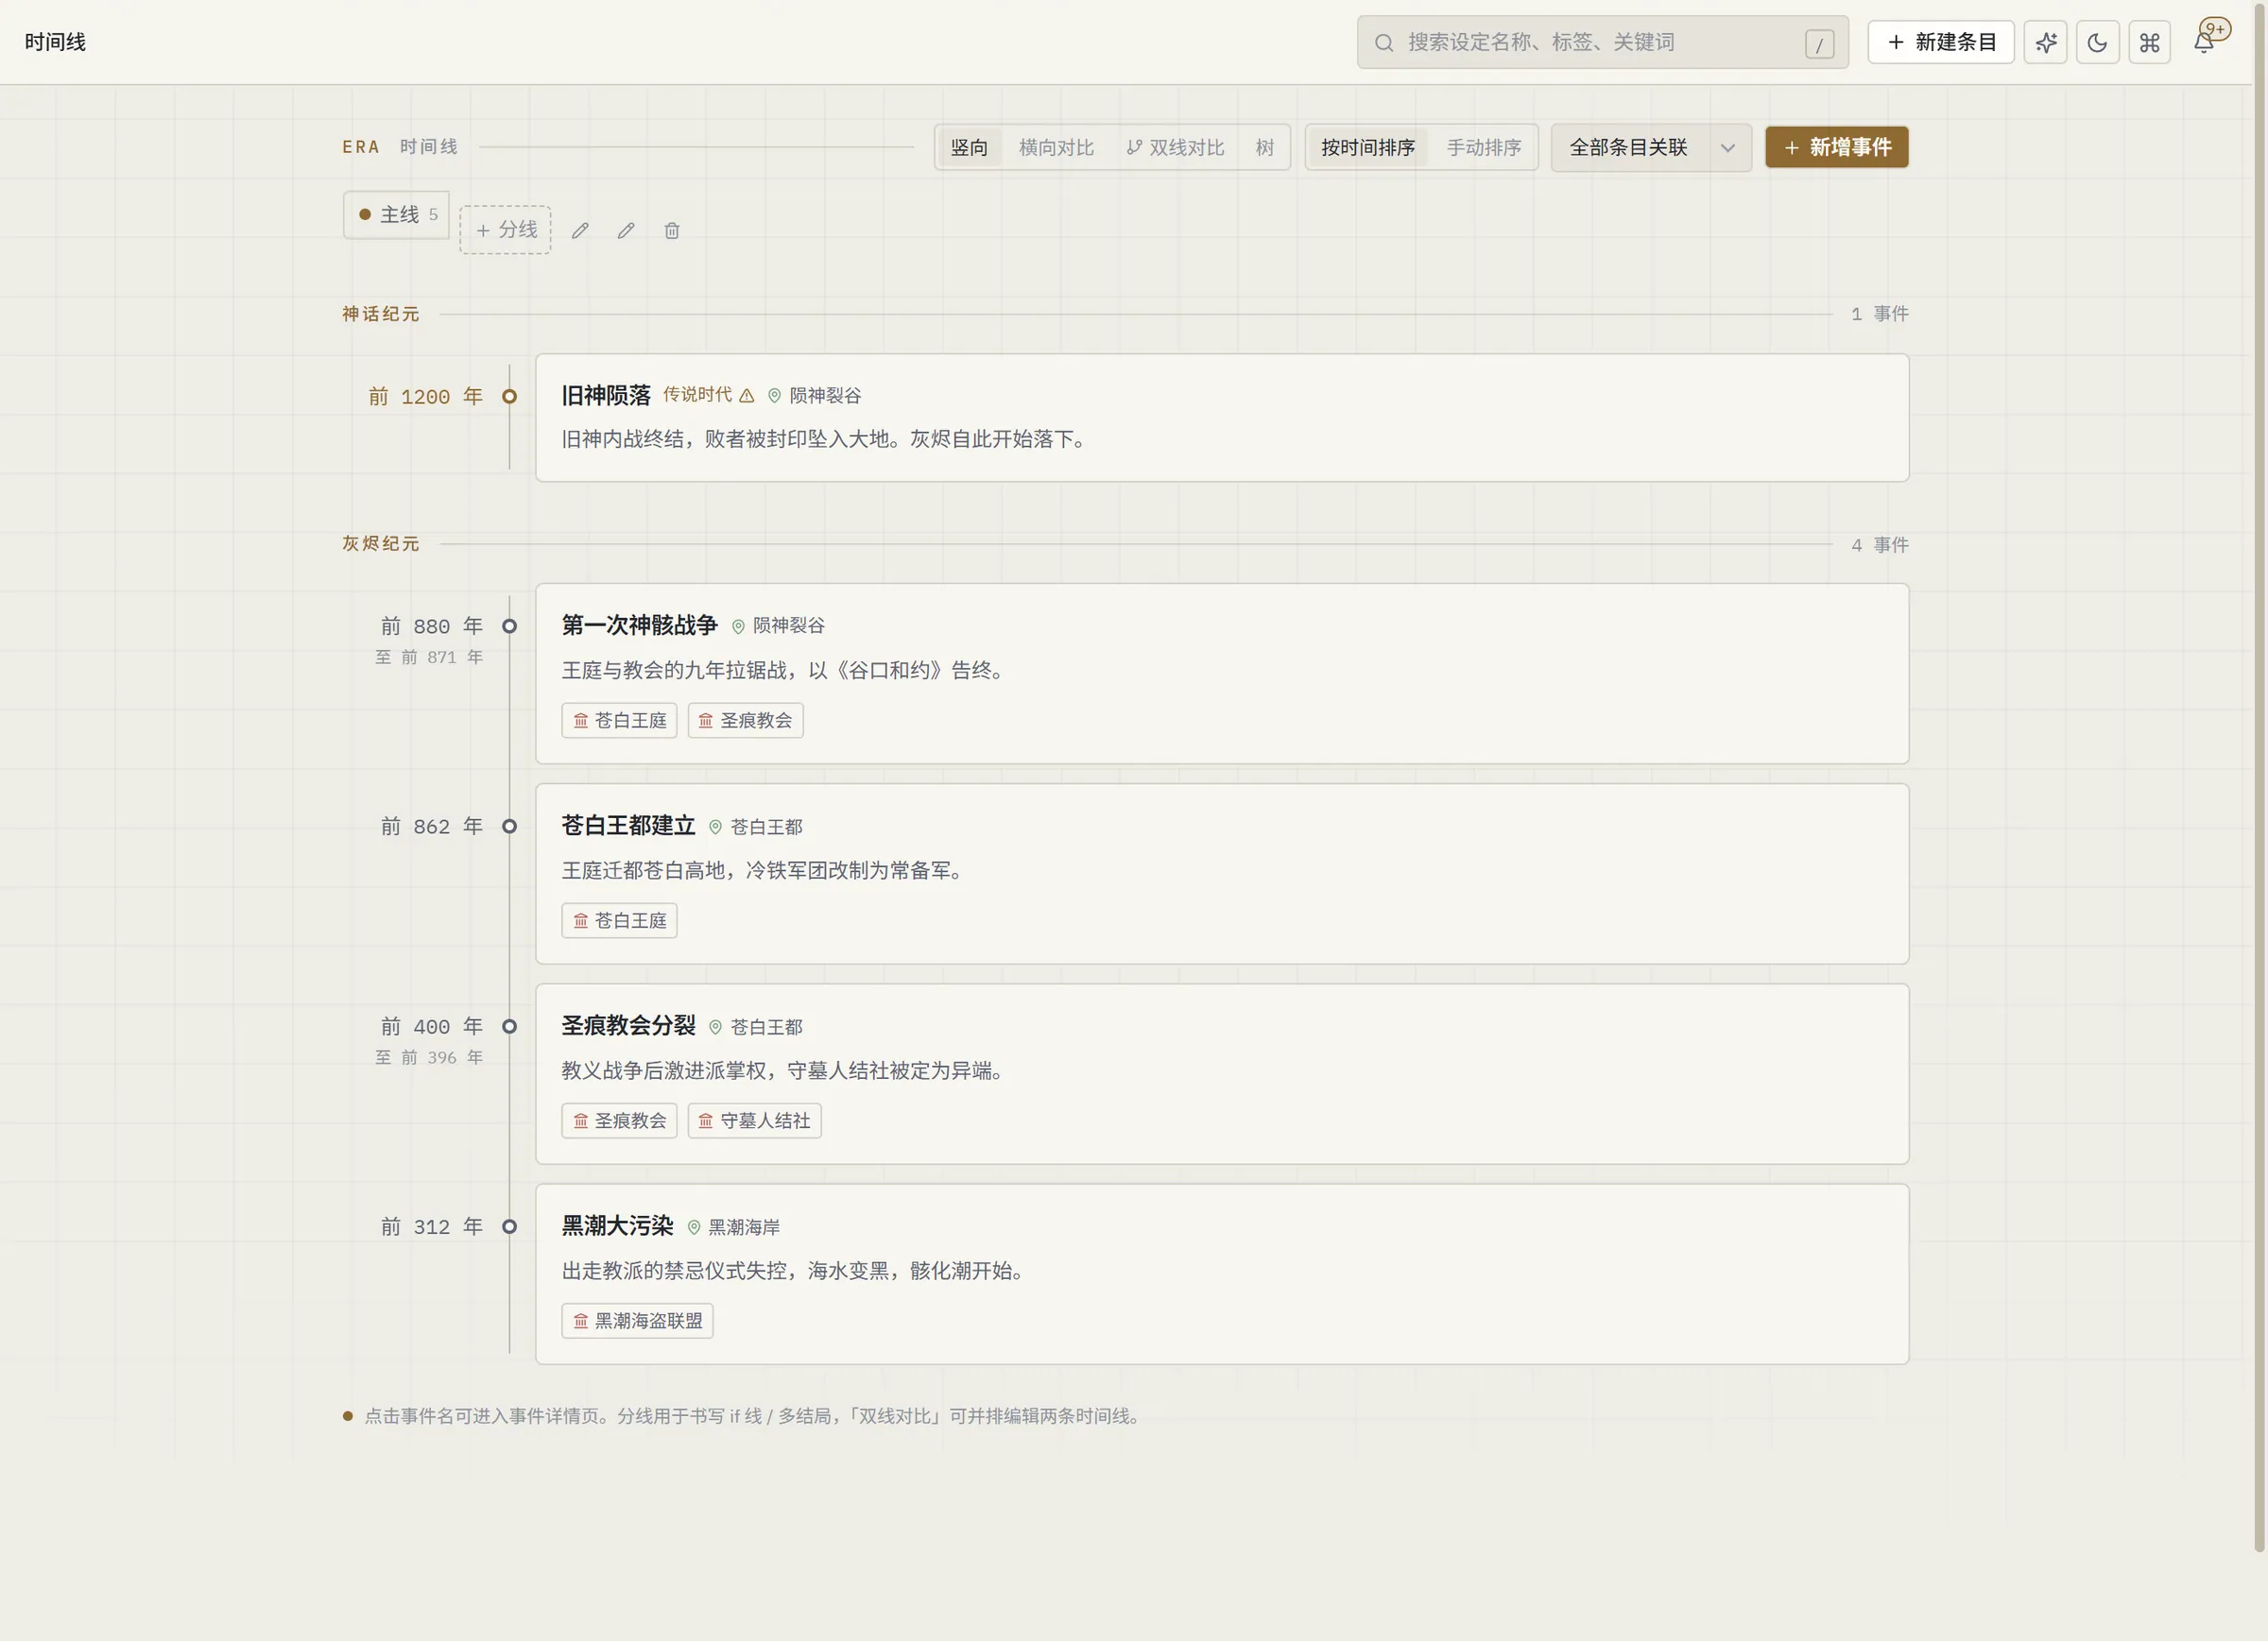
多纪元时间线· 千年历史按纪元铺开,还能开分线写「如果」
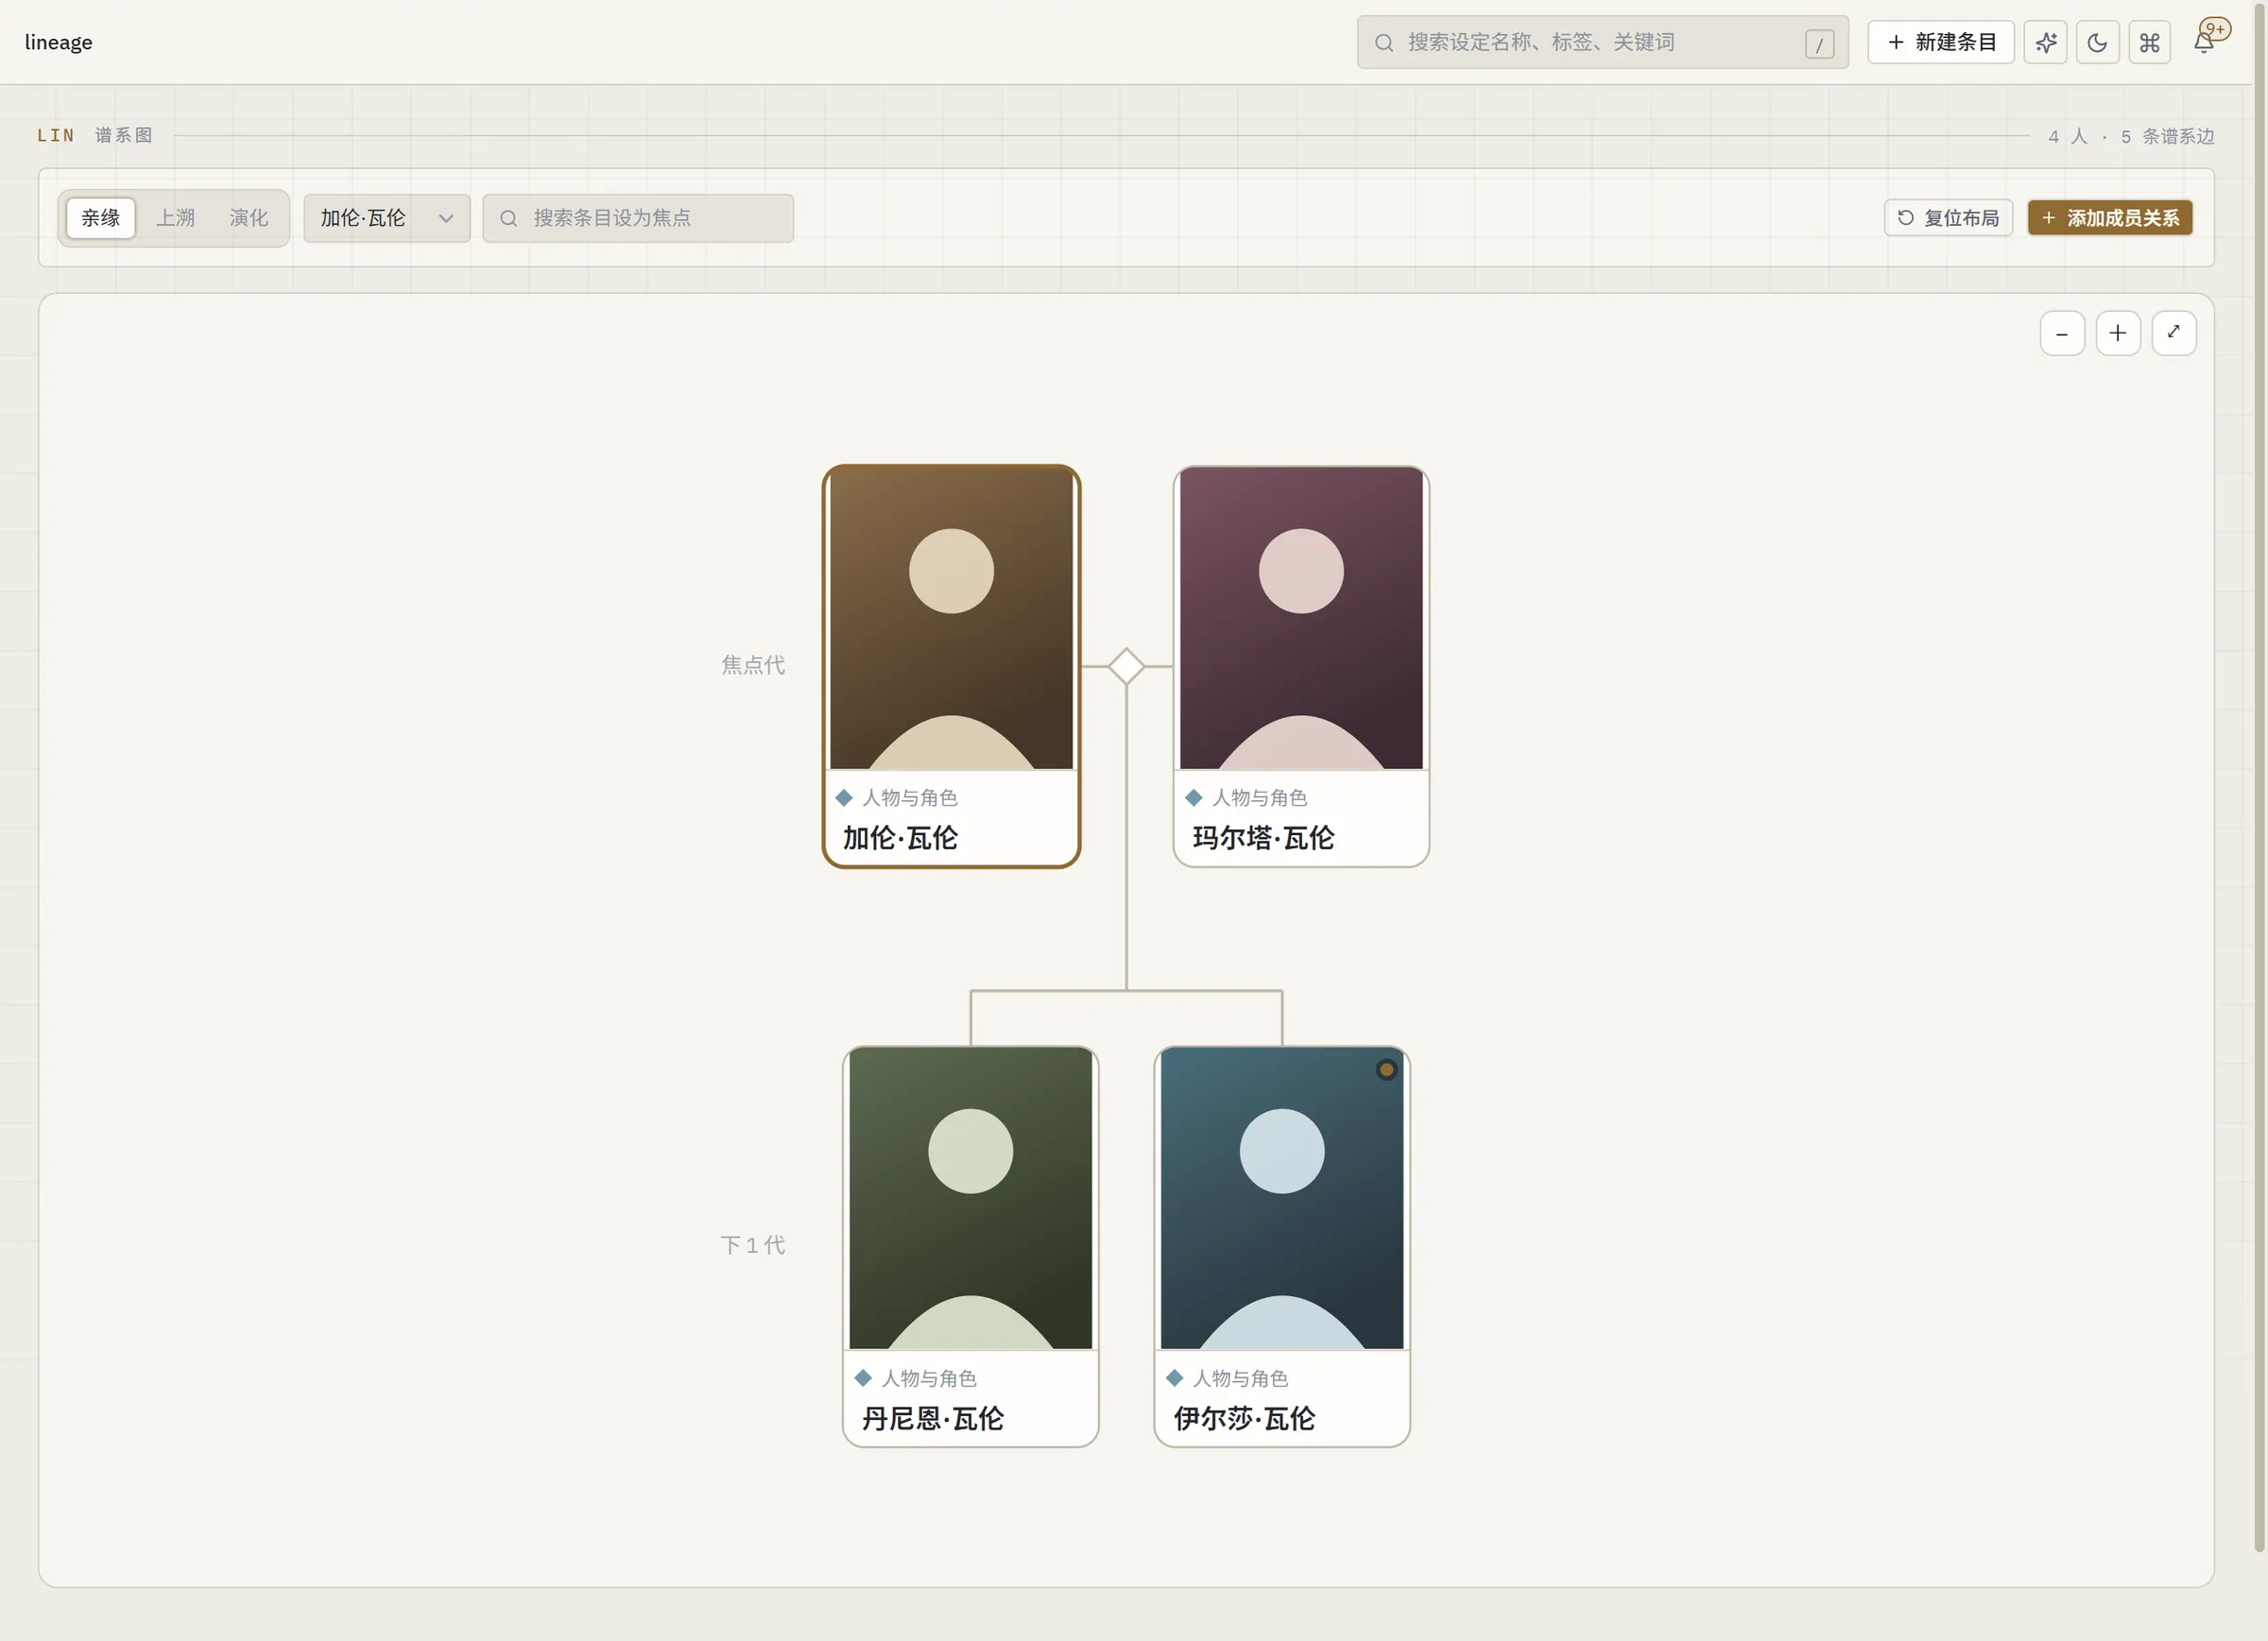
谱系图· 家谱、物种演化、器物传承,同一套树
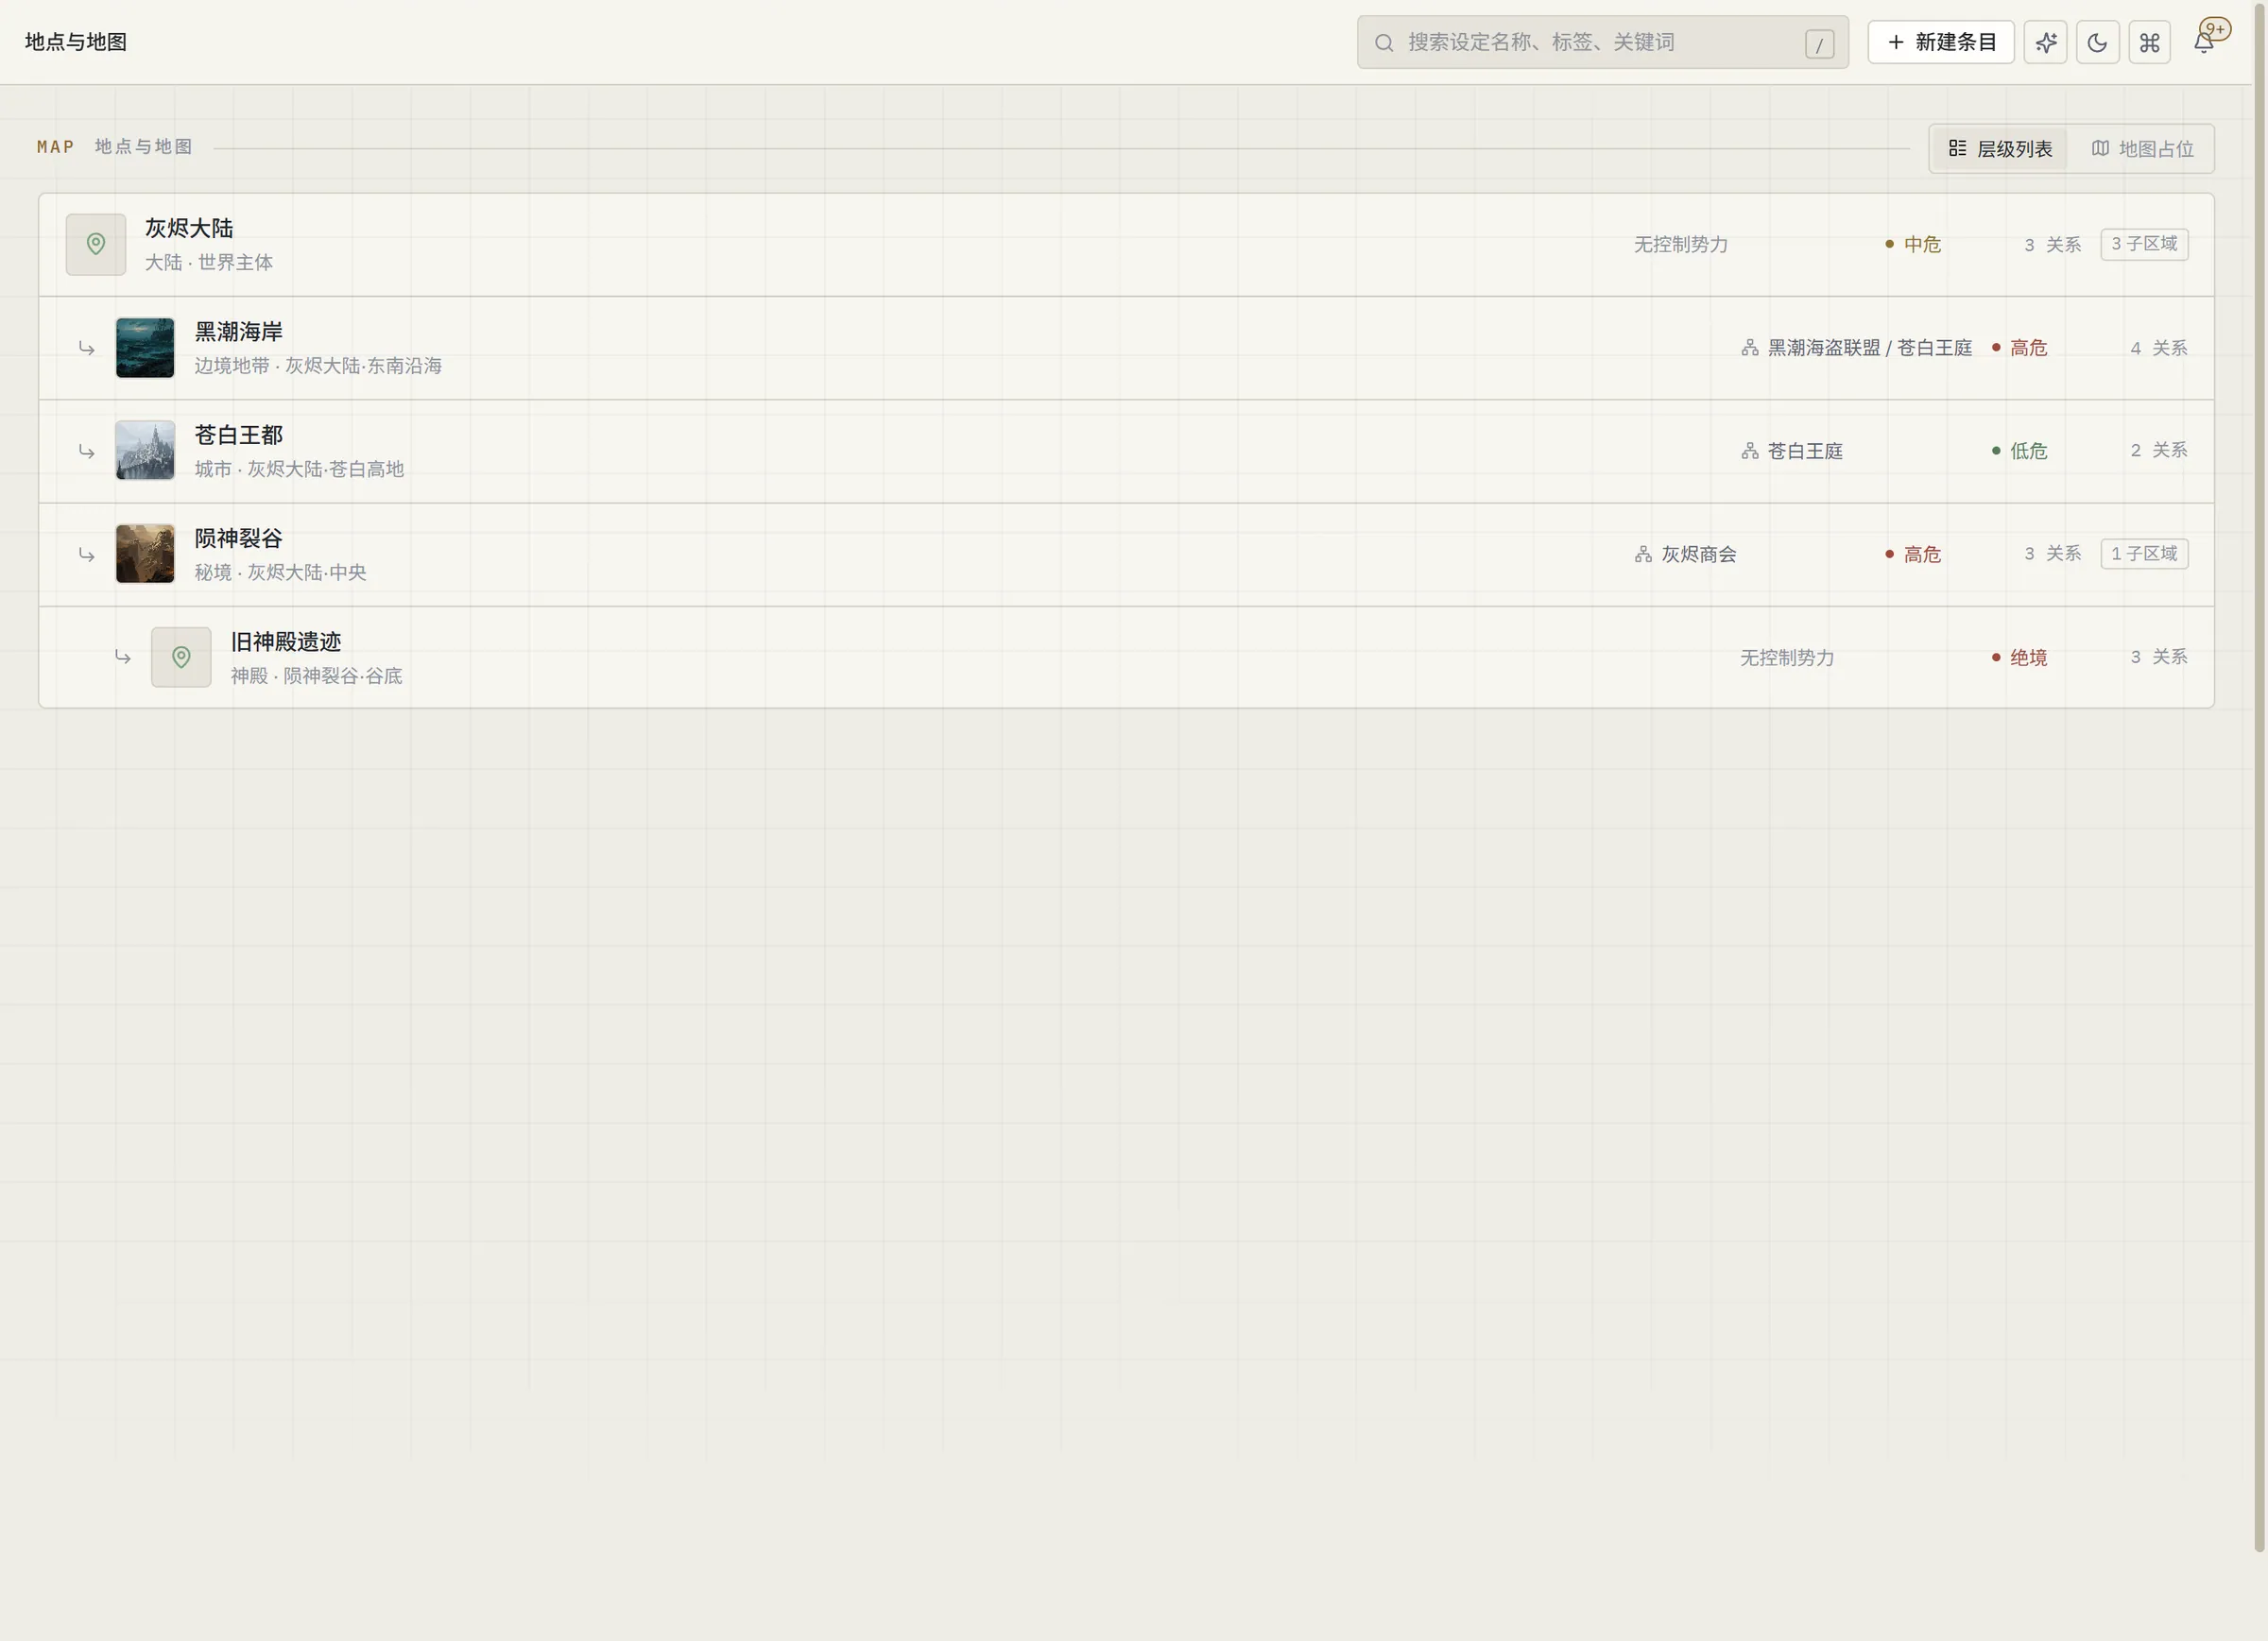
地点与地图· 区域层级(关系也能建层级)+ 多张自定义地图
这不是一句宣传语,而是这个产品的架构选择:所有条目、关系、时间线都存在你浏览器的本地数据库里, 默认不上传服务器。断网照样写,清空浏览数据才需要备份——所以它同时给了你随时导出全部数据的能力。
创作内容默认只写进你浏览器的本地数据库。服务端只处理账号与授权,不碰你的设定正文。
断网也能继续写。数据在本地,打开就是你的档案库,不受网络与服务器状态影响。
整库导出 JSON、单条导出 Markdown、给读者导出可离线打开的展示网页。你的数据永远不是人质。
项目自带一个只读的本地接口:一条命令就能把你的设定集导出成结构化快照(条目 / 关系 / 事件 / 索引), 并附带一个 MCP 服务端——你自己的写作助手、本地模型或知识库,可以直接问「伊尔莎效忠于谁」「第一纪元发生了什么」, 不用每次重新导入整份世界观。
$ node worldset-mcp.mjs --dir "<快照目录>"

# 你的 AI 就能直接问:
  · 列出所有效忠于「苍白王庭」的角色
  · 第二纪元里与「陨神裂谷」有关的事件
  · 「伊尔莎」和「莫拉」是什么关系